Le goulot d’étranglement des données documentaires dans l’IA d’entreprise
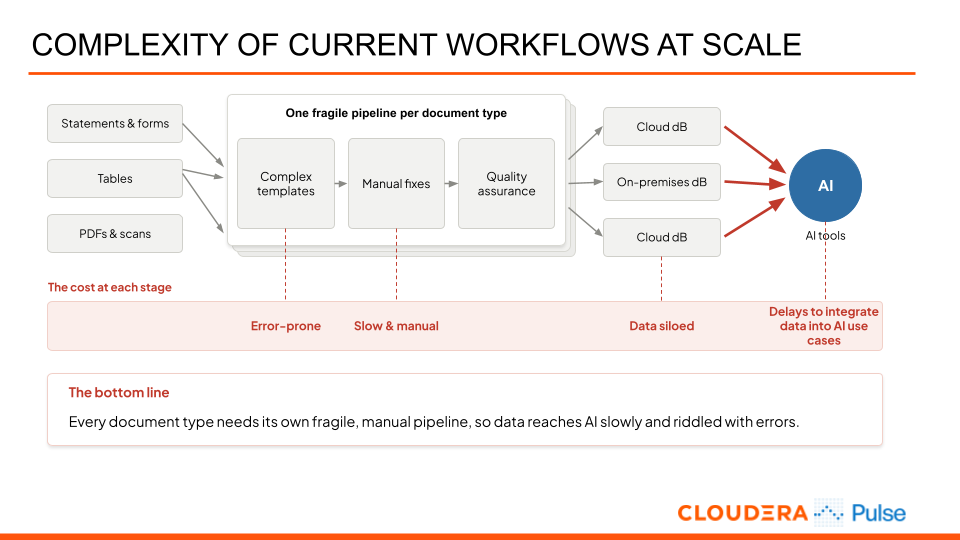
Alors que les données non structurées représentent environ 80 % de l’ensemble des données d’entreprise, elles sont largement sous-exploitées dans l’analyse des données et les cas d’usage de l’IA. Les organisations sont confrontées à une explosion de PDF complexes et de dossiers numérisés que les outils traditionnels de reconnaissance optique de caractères (OCR) et les grands modèles de langage (LLM) à usage général peinent à traiter avec précision à grande échelle. L’approche traditionnelle repose fortement sur une reconnaissance optique de caractères (OCR) fragile, fondée sur des modèles, qui échoue face à la variabilité des documents, à l’écriture manuscrite ou à la mauvaise qualité des numérisations, ce qui entraîne d’importants goulots d’étranglement au niveau de la vérification manuelle. D’un autre côté, les grands modèles de langage (LLM) généraux perdent souvent la structure des documents, ne fournissent pas de citations et présentent un risque réel de générer des valeurs hallucinées. En outre, des données critiques restent enfermées dans des silos architecturaux caractérisés par des modèles de sécurité fragmentés à granularité grossière.
Ces défis empêchent l’intégration des données documentaires dans les cas d’usage de l’IA en raison des taux d’erreur élevés, susceptibles d’entraîner des risques réglementaires (par ex., une mauvaise lecture du plafond de garantie dans un dossier de sinistre, pouvant engager la responsabilité juridique), et des coûts unitaires élevés liés à l’extraction et au traitement des documents, qui limitent l’adoption des données documentaires à grande échelle dans les cas d’usage de l’IA/ML. De plus, les examens manuels, les silos de données disparates aux schémas hétérogènes et les mécanismes de gouvernance de la sécurité variés retardent la mise à disposition de ces données pour les cas d’usage de l’IA/ML, compte tenu des nombreux pipelines ETL nécessaires pour normaliser les résultats extraits selon un schéma commun et les convertir en caractéristiques.
Le partenariat Cloudera et Pulse : une architecture de référence pour une IA documentaire à grande échelle
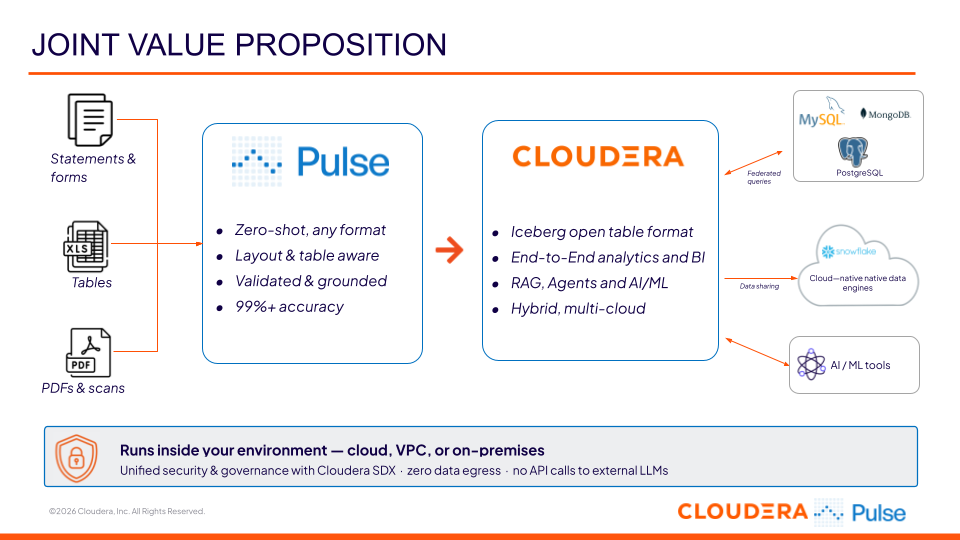
Cloudera et Pulse s’associent pour assurer l’extraction et le traitement de documents à grande échelle, en dépassant les limites des approches traditionnelles :
Pulse remplace plusieurs pipelines d’extraction de données pour les PDF complexes, les notes manuscrites, les tableaux et les graphiques par un pipeline unique à plusieurs étapes et faisant appel à plusieurs modèles, qui fournit des données très précises et prêtes pour l’audit. Chaque étape d’extraction des données est exécutée par un modèle conçu précisément pour cette tâche, et le « Pulse Brain » est capable de comprendre le contexte sémantique et la mise en page du document, puis d’analyser les résultats afin de détecter les erreurs avant la sortie.
Cloudera propose une plateforme centralisée et ouverte de data lakehouse et d’IA d’entreprise qui intègre les données en flux, l’ingénierie des données, l’entreposage des données et le ML/GenAI à grande échelle, avec une couche unifiée de sécurité et de gouvernance grâce à SDX. Ce cadre propose des contrôles d’accès aux données basés sur les attributs, la traçabilité ainsi que l’enrichissement et le catalogage actifs des métadonnées.
Cette combinaison crée une architecture technologique unifiée qui intègre les données structurées et les données documentaires (traitées par Pulse) dans un cadre commun de sécurité et de gouvernance, à l’aide d’un tableau de bord unique couvrant différents environnements de Cloud public et privé. L’architecture permet de normaliser les flux de travail d’ingénierie des caractéristiques à travers des sources de données disparates et diverses, et de croiser les données structurées et documentaires dans des cas d’usage d’IA/ML. En outre, elle fournit une couche unifiée de partage des données qui expose les données structurées et documentaires aux outils externes, sur site ou dans le Cloud.
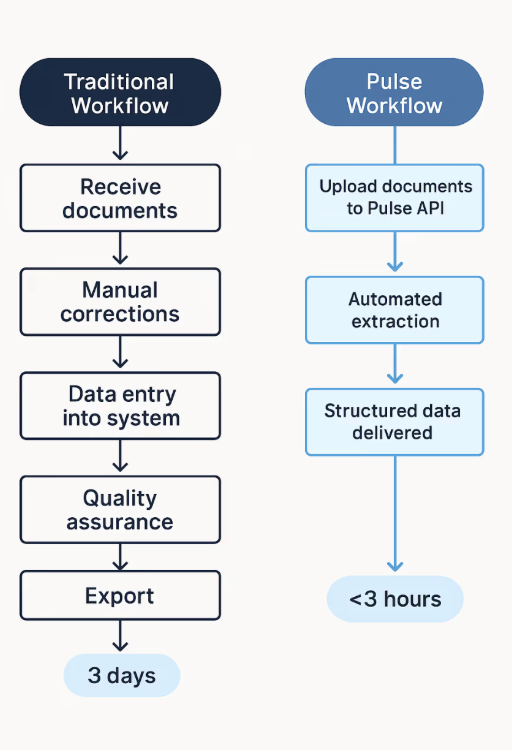
De plus, la proposition de valeur collaborative réduit le temps nécessaire à l’intégration des données documentaires dans les cas d’usage de l’IA en éliminant les corrections manuelles et les tâches d’assurance qualité, qui prendraient généralement jusqu’à trois jours, ramenant ainsi le délai d’extraction à moins de trois heures:
Cloudera améliore les charges de travail d’ingénierie des données et d’inférence LLM jusqu’à 20x et 36x, respectivement. De même, Pulse emploie plusieurs optimisations GPU et CPU afin de réduire le coût unitaire de l’extraction, augmentant ainsi l’utilisation des GPU de 30 %.
Conçu pour les données sensibles et les secteurs réglementés
Dans les secteurs réglementés tels que les services financiers et la santé, le coût d'une erreur d'extraction non détectée se chiffre en millions de dollars ou en risques réglementaires, et ne se résume pas à un simple problème de qualité. Par exemple, un séparateur décimal mal placé ou un point interprété comme une virgule pourrait entraîner d’importantes erreurs de vérification AML/KYC, et donner lieu à des amendes réglementaires substantielles.
La solution Cloudera et Pulse est explicitement conçue pour les données sensibles et les industries réglementées ; elle peut être entièrement déployée dans le Cloud privé virtuel (VPC) d’un client, sans sortie publique pour l’extraction de documents ou les analyses avancées.
Pulse propose une approche de niveau production de la vérifiabilité des données, en garantissant que chaque champ extrait est directement rattaché à son emplacement exact sur la page source, tout en préservant le contexte et les relations hiérarchiques qui assurent une extraction documentaire presque sans faille. Plus précisément pour les données de feuilles de calcul, cette solution peut saisir la mise en page, les conventions de formatage et les nuances propres au secteur financier afin de surmonter les limites des approches traditionnelles (par exemple, l’abandon des colonnes masquées, la gestion des données hiérarchiques, etc.).
Le lakehouse de données ouvert de Cloudera fournit, par l’intermédiaire de SDX, un mécanisme de sécurité des données à granularité fine qui répond à des exigences réglementaires strictes, telles que la conformité BPx dans les sciences de la vie. Cloudera Data Lineage suit les relations structurelles approfondies entre les données, depuis le document numérisé brut jusqu’aux entrées de la base de données vectorielle, et crée des enregistrements de traçabilité prêts pour la conformité.
Jouer un rôle démultiplicateur pour les initiatives d’IA
La proposition de valeur collaborative est particulièrement pertinente pour les initiatives d’IA. À mesure que les capacités des modèles d’IA se banalisent fortement, la véritable source de différenciation concurrentielle pour une entreprise s’est radicalement déplacée : elle ne réside plus dans l’accès brut aux modèles, mais dans les données propriétaires. Cloudera et Pulse aident les entreprises à tirer parti en toute sécurité de cet immense avantage concurrentiel en transformant des référentiels de documents non structurés en ressources de grande qualité et exploitables. Ensemble, Cloudera et Pulse améliorent considérablement la précision sémantique des recherches vectorielles dans Cloudera RAG Studio et transforment des bases documentaires hautement sensibles et propriétaires en un socle complet pour une veille stratégique sécurisée et des pipelines agentiques avancés.
Créer de la valeur pour l’entreprise à grande échelle
Dans les déploiements en entreprise, Pulse a obtenu des résultats sans précédent par rapport aux approches traditionnelles d’extraction de documents.
Pour une grande compagnie d’électricité, elle a converti 1,2 million de documents de terrain manuscrits, atteignant une précision de 97,5 % pour des données qu’aucun système n’avait pu numériser avec précision depuis des décennies. Pour un grand courtier en assurance, il s’agissait du premier système à fournir systématiquement une précision de 99 % sur les données documentaires traitées par plusieurs équipes offshore, réduisant de 76 % le temps nécessaire pour produire un résultat structuré complet et vérifiable.
En savoir plus sur les capacités de Cloudera et la plateforme Pulse.