
Éliminer le goulot d’étranglement de la gouvernance de l’IA en entreprise avec Cloudera Agent Studio 3.0
Les entreprises s'emploient activement à mettre en production des agents d'IA différenciés et à forte valeur ajoutée. Mais les agents les plus précieux dépendent des données dont les organisations peuvent le moins se permettre de perdre le contrôle : des données sensibles et propriétaires.
Cela crée immédiatement un défi de gouvernance. Dans de nombreuses architectures traditionnelles, les agents doivent déplacer les données hors du stockage géré et vers des plateformes SaaS externes avant de pouvoir les utiliser. Dès que cela se produit, les organisations perdent la capacité de gouverner entièrement les données à leur source et héritent de trois risques qui se cumulent :
Sécurité : Chaque exportation crée une copie externe de données sensibles, élargissant la surface d’attaque et obligeant les équipes à gérer, à corriger et à auditer séparément un ensemble de données parallèle à leur source de vérité.
Performances : l’acheminement aller-retour des données vers une plateforme externe introduit de la latence et supprime les optimisations de requêtes intégrées au stockage géré, ce qui ralentit considérablement l’exécution des agents par rapport aux capacités de l’infrastructure sous-jacente.
Coût : L’extraction de données au-delà des périmètres du Cloud à grande échelle augmente les frais de sortie, souvent de manière imprévisible, car les charges de travail des agents interrogent les données à plusieurs reprises au lieu de le faire une seule fois.
Les données et l'intelligence artificielle dont nous avons besoin pour créer une valeur véritablement différenciée sont souvent celles qui présentent le plus grand risque si elles échappent à notre contrôle. Par conséquent, les équipes chargées de la conformité et de la sécurité qui évaluent précisément ces risques sont souvent contraintes d’intervenir, mettant un terme à des initiatives prometteuses au moment même où elles franchissent l’étape de la preuve de concept.
Les cinq obstacles structurels à l’IA en production
Par nature, les flux de travail agentiques, qui associent des LLM de raisonnement, des interfaces d’outils, une planification structurée des tâches et des boucles d’exécution continues, ne peuvent pas fonctionner en toute sécurité sur une infrastructure isolée. Ils nécessitent un accès direct aux ressources de calcul pour les socles de données gérées. Lorsqu’elles sont contraintes d’adopter des configurations fragmentées impliquant le transfert de données, les organisations se heurtent à cinq obstacles distincts :
Autonomie en boîte noire et risques liés à l’audit : les décisions autonomes en plusieurs étapes engendrent des risques réglementaires. La journalisation système standard consigne les appels aux points de terminaison, mais ne capture pas la planification interne des tâches des sous-agents, les entrées et sorties spécifiques des charges utiles des outils, ni l’identité de l’utilisateur authentifié à l’origine de chaque étape.
Dérive de la gouvernance entre équipes cloisonnées : Lorsque les équipes métier créent des prototypes visuels dans des outils SaaS non surveillés, tandis que les ingénieurs écrivent des scripts d’orchestration Python personnalisés dans des environnements distincts, l’architecture technique se fragmente. Cette dualité contourne les contrôles d’accès centralisés et entraîne une dérive de la gouvernance.
Fragilité des invites et nouvelles tentatives d’exécution : Les frameworks d’agents traditionnels donnent des instructions aux modèles au moyen d’invites textuelles non structurées. Lorsque les LLM génèrent du texte libre plutôt que des schémas de charges utiles structurés, les chaînes d’exécution se brisent. Les nouvelles tentatives du système consomment des jetons d’API supplémentaires, augmentent la latence des requêtes et provoquent des échecs dans les parcours d’exécution en plusieurs étapes.
Frais de sortie du Cloud et inflation des jetons : L’extraction d’ensembles de données opérationnels au-delà des périmètres du Cloud vers des hôtes externes génère des frais récurrents de sortie de données. Transmettre un contexte non structuré et non sélectionné aux fenêtres de contexte de LLM externes augmente le nombre de jetons utilisés pour chaque requête, ce qui accroît le coût d’inférence par requête sans améliorer la précision du raisonnement.
Dépendance aux API et coûts fixes de calcul : le codage en dur de la logique d’orchestration dans des API de modèles propriétaires enferme les entreprises dans une tarification fixe du calcul. Les équipes d’infrastructure perdent la flexibilité d’acheminer les appels de fonction courants vers des modèles locaux de paramètres moins coûteux, tout en réservant les API de pointe tierces au raisonnement complexe.
Comment Cloudera Agent Studio assure une exécution gouvernée
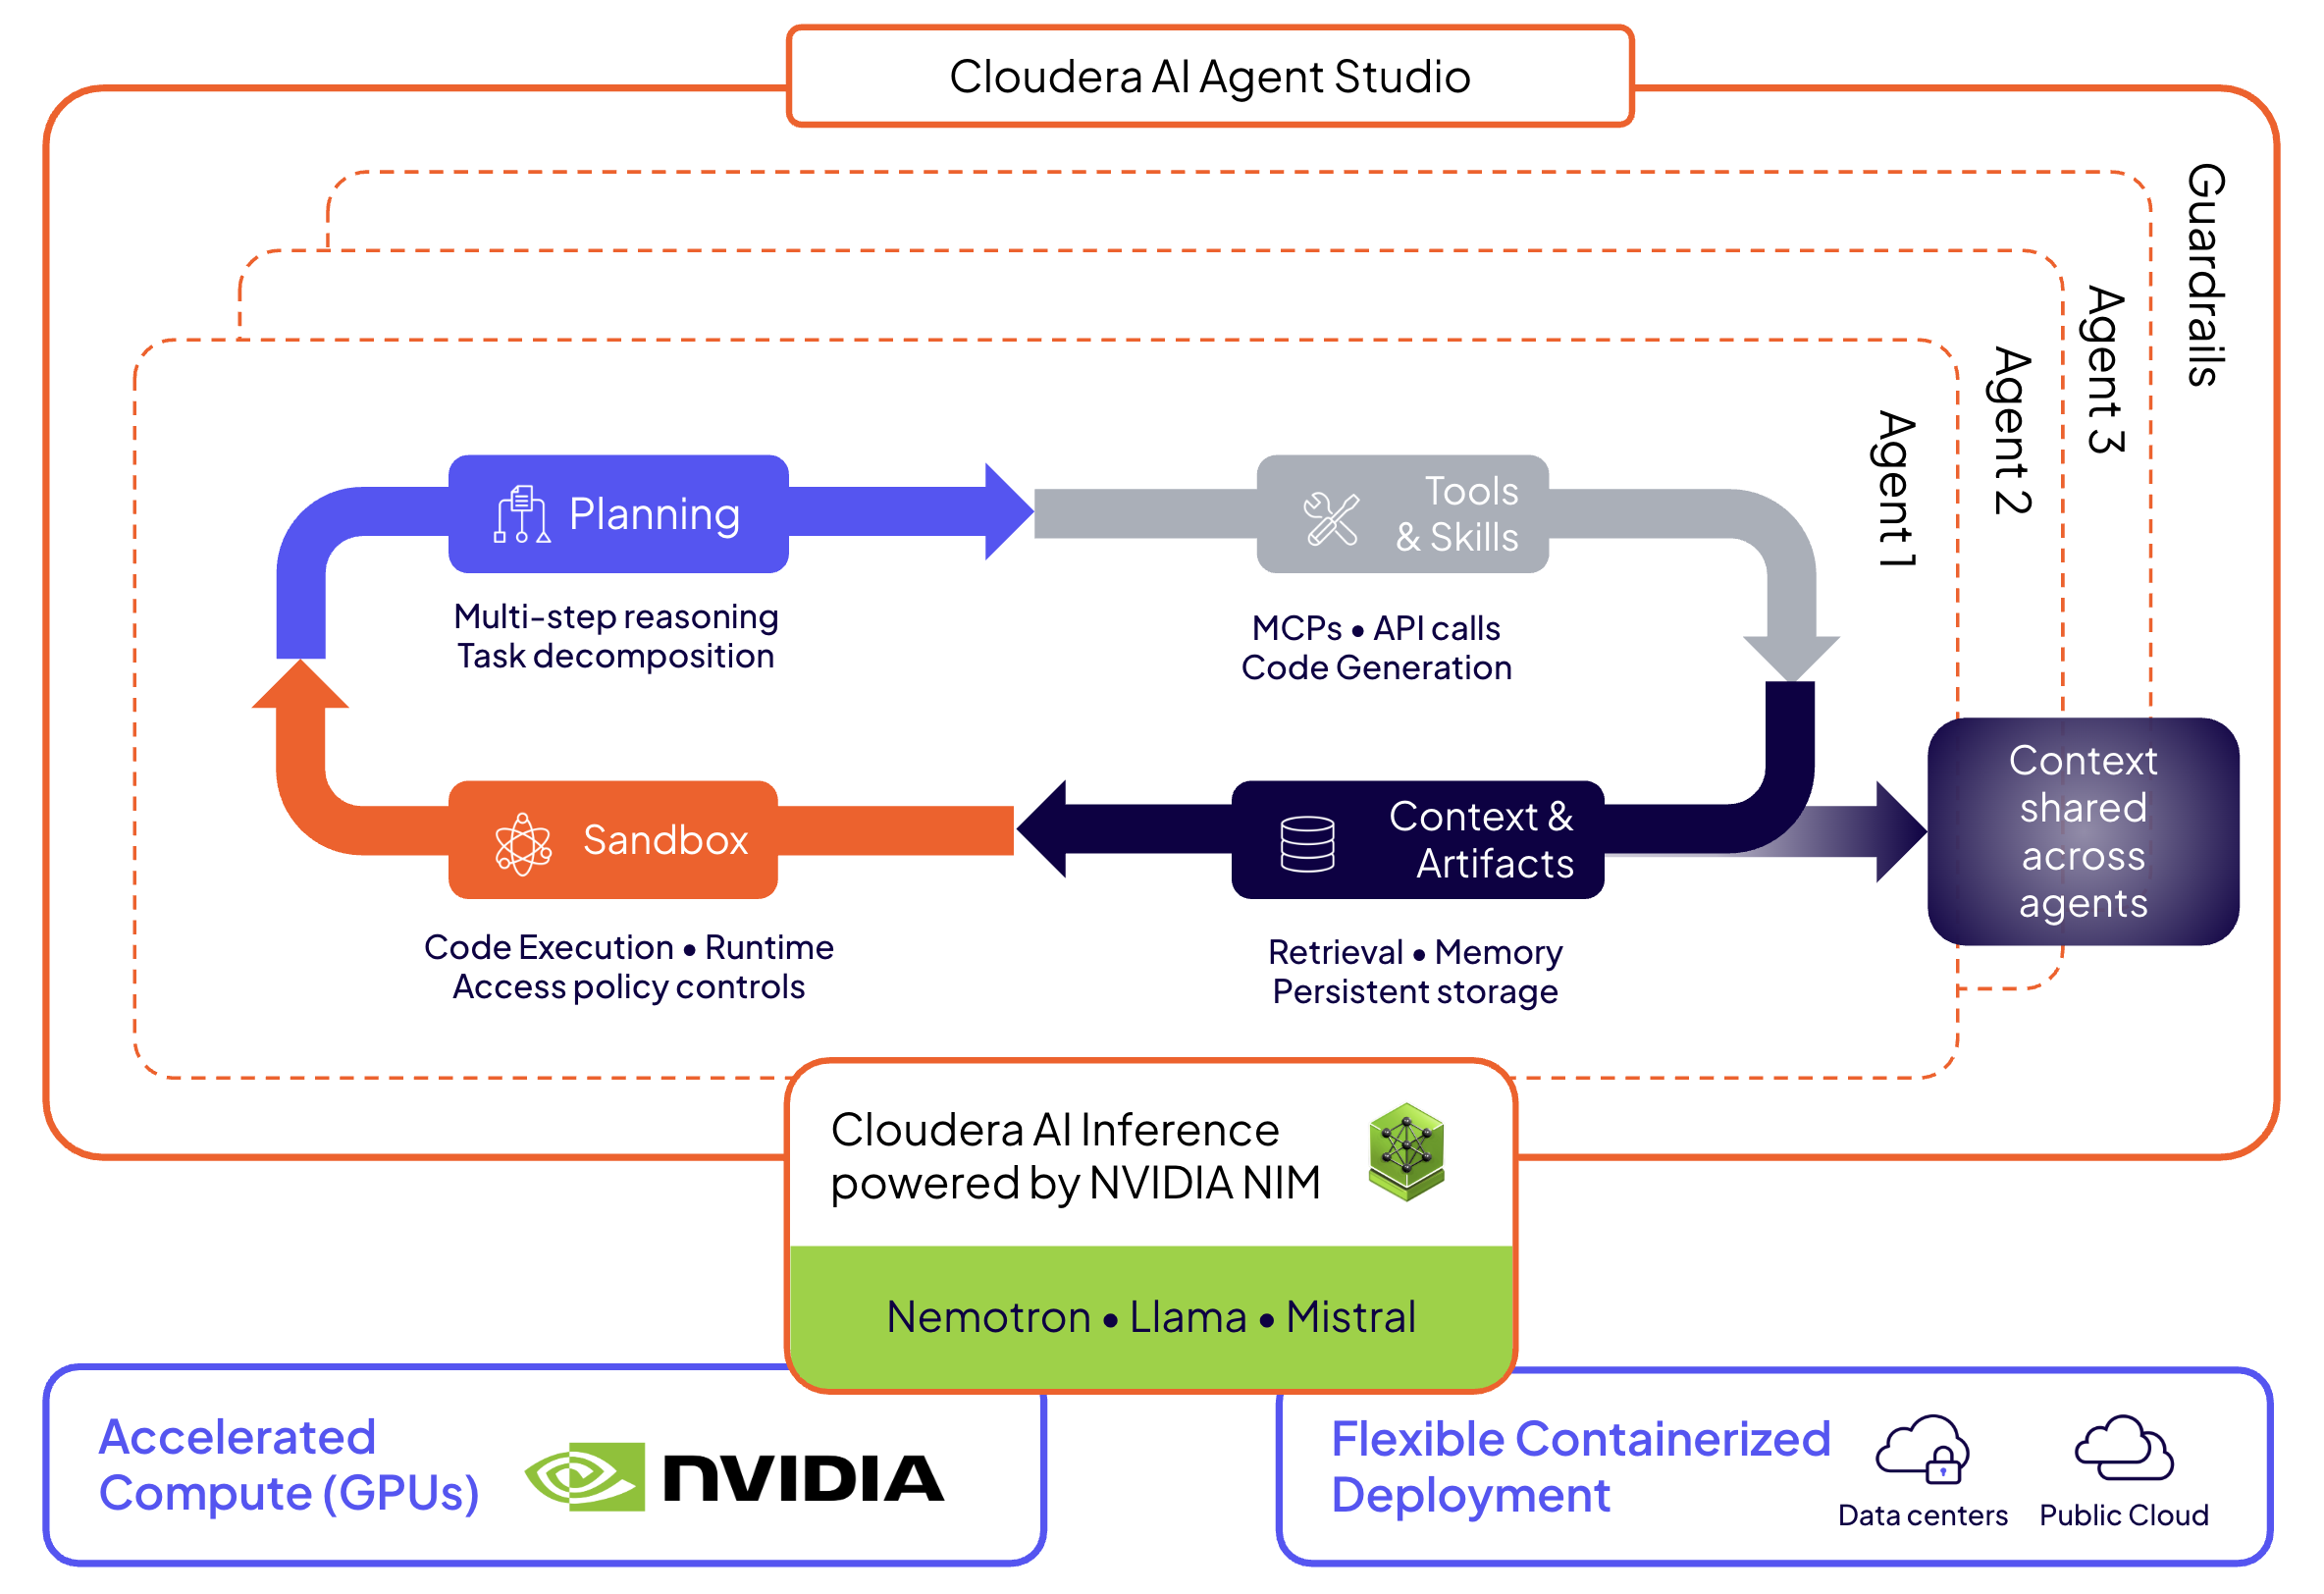 Architecture d’Agent Studio 3.0
Cloudera Agent Studio 3.0 répond à ces défis structurels en exécutant des workflows d’IA autonomes directement là où se trouvent vos données. En fournissant un moteur d’exécution gouverné reposant sur les fondations existantes des services de données Cloudera, il élimine systématiquement chacun des cinq obstacles structurels :
1. Journaux d’audit immuables et garde-fous
Résoudre les problèmes d’autonomie en boîte noire et les risques liés à l’audit
Pour atténuer le risque réglementaire et éliminer l’exécution en boîte noire, l’activité du système est enregistrée dans des journaux d’audit structurés et en mode ajout uniquement. Les équipes de conformité bénéficient d’une visibilité de bout en bout, capturant les identités des utilisateurs authentifiés, les horodatages à la microseconde près, les types d’opérations, les identifiants de ressources, les entrées d’invites, et les résultats d’outils spécifiques.
Regardez : les garde-fous en temps réel en action
La sécurité de l’exécution est garantie en continu par les mécanismes en temps réel suivants :
Masquage des données personnelles : Anonymise les données sensibles avant leur transmission à la fenêtre de contexte du modèle.
Filtres de contenu : règles déterministes basées sur le texte qui protègent contre l’injection de prompt ou bloquent l’exécution en fonction de mots-clés.
Juge LLM intégré : valide les charges utiles d’entrée et de sortie des outils au regard des règles de conformité de l’entreprise.
Garde-fou personnalisé : Applique par programmation des garde-fous adaptés aux exigences de votre entreprise.
Pour en savoir plus, consultez notre documentation sur les garde-fous.
2. Workflows unifiés à deux pistes
Résoudre la dérive de gouvernance entre équipes cloisonnées
Agent Studio 3.0 unifie le développement technique et non technique au sein d’un moteur d’orchestration unique, faisant le lien entre la séparation architecturale des équipes métier et d’ingénierie :
Pour les analystes métier : Créez visuellement des flux de travail à l’aide d’un catalogue de modèles d’outils prédéfinis et de connecteurs MCP.
Pour les ingénieurs en IA : rédigez une logique Python personnalisée dans Cloudera AI Workbench.
Comme les deux voies sont compilées dans des environnements d’exécution identiques, elles partagent les mêmes contrôles de sécurité de la plateforme et éliminent la dérive de gouvernance liée à l’IA fantôme.
3. Appel de fonctions contrôlable et mise en bac à sable
Résoudre les problèmes de fragilité des invites et de nouvelles tentatives d’exécution
Pour éliminer les chaînes d’exécution fragiles basées sur des invites textuelles, la plateforme exploite les protocoles natifs d’appel de fonctions des LLM. Elle transmet des schémas JSON formels au modèle afin de générer des objets d’appel d’outils fortement typés.
Sandbox des containers : Chaque processus d’agent s’exécute dans des environnements sandbox isolés de containers, configurés sans aucune autorisation système par défaut ; toute élévation de privilèges nécessite l’approbation explicite d’une politique au niveau de la plateforme.
Planification structurée : Avant l’exécution, les agents élaborent un plan de tâches structuré afin que les opérateurs puissent suivre de manière déterministe la progression étape par étape.
4. Calcul localisé sur des données gérées via MCP
Résoudre les frais de sortie du Cloud et l’inflation des jetons
Les agents interagissent directement avec le stockage d’entreprise sans extraction ni réplication des données. Les agents exécutent des requêtes sur des données analytiques structurées dans Cloudera Data Warehouse, traitent les entrées en continu via Cloudera DataFlow et transmettent les résultats à Cloudera Data Visualization.
Les connecteurs utilisant le Model Context Protocol (MCP) relient directement les agents aux formats de tables ouverts, tandis que les politiques de gouvernance de Cloudera Shared Data Experience (SDX) appliquent des contrôles d’accès basés sur les rôles et suivent les métadonnées à chaque interaction, ce qui permet de maintenir les données bien contextualisées et les frais de sortie à zéro.
5. Neutralité des modèles et contrôle FinOps
Résoudre la dépendance aux API et les coûts fixes de calcul
Agent Studio 3.0 dissocie complètement l’orchestration des modèles de langage sous-jacents. Les équipes peuvent cibler des API tierces (OpenAI, Anthropic, Amazon Bedrock) ou déployer localement des modèles open source via le service Cloudera AI Inference.
Changer de cible de modèle nécessite de mettre à jour les configurations des points de terminaison dans la couche d’orchestration, sans modifier le code de l’agent ni les schémas des outils. Les architectes système réduisent le coût total de possession (TCO) en acheminant les appels de fonctions courants et à haut volume vers des modèles comportant moins de paramètres et hébergés localement, en réservant les jetons coûteux des API tierces strictement au raisonnement complexe en plusieurs étapes.
Résultats opérationnels quantifiés
Industrie |
Scénario opérationnel |
Valeur pour l’entreprise |
Services financiers |
Évaluer la solvabilité de comptes commerciaux dont le dossier de crédit est peu étoffé à partir d’ensembles de données dépassant 100 millions d’enregistrements. |
Réduit les cycles de souscription de plusieurs jours à quelques minutes tout en générant des pistes d’audit prêtes à être présentées aux autorités de réglementation. |
Télécommunications |
Traiter plus de 50 000 événements en continu par seconde via Data Flow pour détecter les signaux d’attrition. |
Déclenche des workflows automatisés de conservation en temps réel sans déplacer les données hors des systèmes opérationnels. |
Santé et sciences de la vie |
Extraire les codes de diagnostic des dossiers cliniques non structurés provenant de dossiers médicaux disparates. |
Accélère le traitement de données d’essais cliniques au sein d’environnements d’exécution isolés. |
Assurance |
Mettez en corrélation les enquêtes non structurées sur les sites immobiliers avec les principales bases de données transactionnelles. |
Identifie les facteurs de risque omis et automatise le rapprochement des données inter-systèmes. |
Logiciels et technologie |
Effectuez le triage des incidents de production de niveau 2 dans des environnements d’exécution de conteneurs isolés. |
Résout les alertes applicatives et met à jour les paramètres d’état du système sans escalade humaine. |
Votre avenir avec l’IA agentique gouvernée
La transition de workflows autonomes depuis des prototypes isolés vers des systèmes de production nécessite de résoudre les tensions entre l’innovation rapide et le contrôle de l’entreprise. Pendant trop longtemps, l’écart entre la validation du concept et le déploiement a contraint les équipes à choisir entre l’agilité de l’IA autonome et la sécurité d’une gouvernance centralisée.
Cloudera Agent Studio 3.0 comble cet écart.
En exécutant le calcul directement là où résident les données, Agent Studio 3.0 élimine systématiquement les cinq principaux obstacles à la mise en production de l’IA : les frais de sortie du Cloud, la fragilité de l’exécution, la dérive de gouvernance, l’ambiguïté des audits et le verrouillage lié au calcul. Le déploiement de l’IA agentique d’entreprise ne nécessite plus de compromis architecturaux.
Prêt à mettre vos agents d’IA en production ? Obtenez les stratégies et les compétences nécessaires pour passer du développement à la production dans notre série de webinaires en 7 parties sur l’IA d’entreprise et l’IA agentique.